Total Recall: Память агентов и Harness Engineering
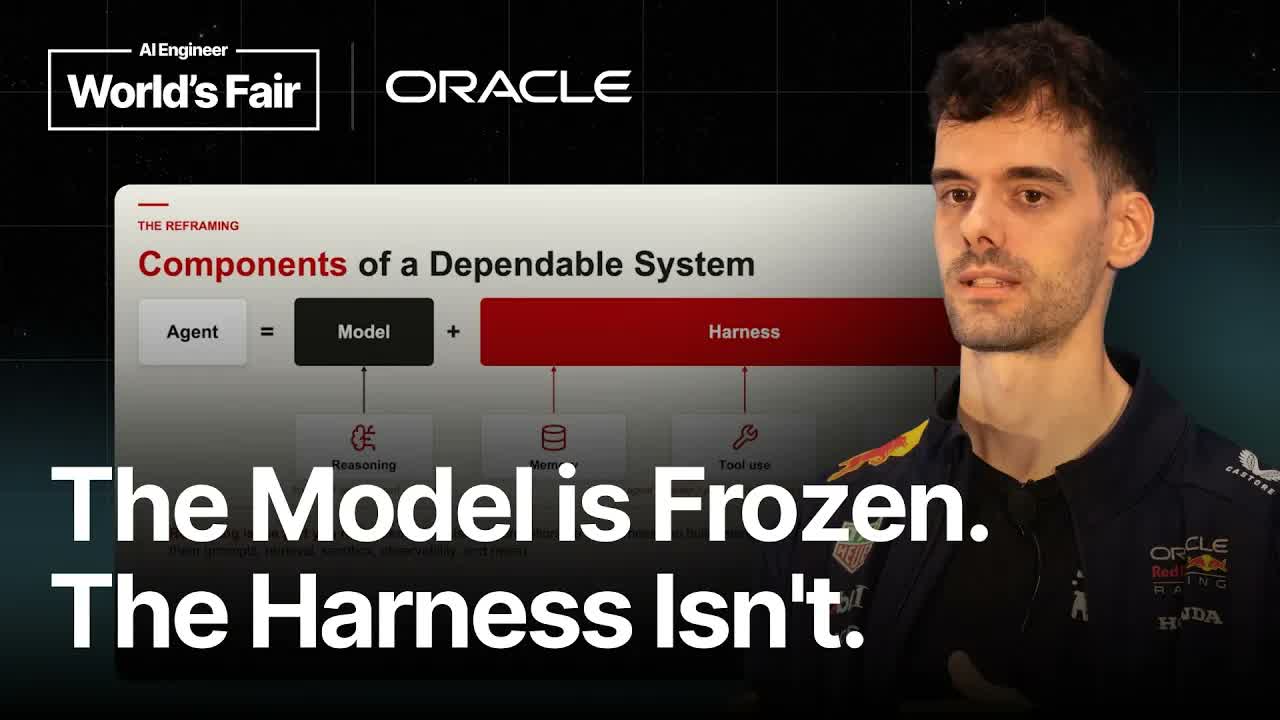
Главный тезис: Языковая модель — это застывшее ядро рассуждений, которое мы арендуем у лабораторий. Её веса зафиксированы. Всё, чем разработчик реально управляет и что превращает недетерминированную генерацию в предсказуемый и надежный результат, находится в обвязке (Harness). Агент — это модель плюс обвязка.
TL;DR: Ключевые идеи доклада за 2 минуты
Что нужно знать о современной архитектуре автономных систем и долгосрочной памяти LLM-агентов.
Агент = Модель + Обвязка
Веса модели неизменны и зафиксированы при обучении. Модель — заменяемый и арендуемый ресурс. Все адаптации, правила компании, долговременная память, обращение к инструментам и устойчивость к сбоям конструируются вокруг модели инженером обвязки.
Файлы против Баз данных
Файлы привычны моделям, но лишены транзакционности. При параллельной работе 8–32 агентов возникает перезапись данных. Сообщество обходит это через Git Worktrees, хотя реляционные БД решили проблему изоляции (ACID) десятилетия назад. Оптимален гибрид: кратковременная память в файлах, долговременная — в БД.
Окно контекста не решит проблему
Увеличение контекста до миллионов токенов ведёт к Context Rot: внимание рассеивается квадратично. Решение — упреждающее сжатие (Compaction в Context Card) и выгрузка тяжелых артефактов (Offloading) наружу с сохранением указателей.
Семантический слой как линза
По концепции биолога Якоба фон Икскюля каждый организм видит мир только через доступные рецепторы. Для агента семантический слой — это линза, выражающая скрытое невысказанное знание (tribal knowledge) компании: схемы, бизнес-правила и термины.
Навыки живут на системном уровне
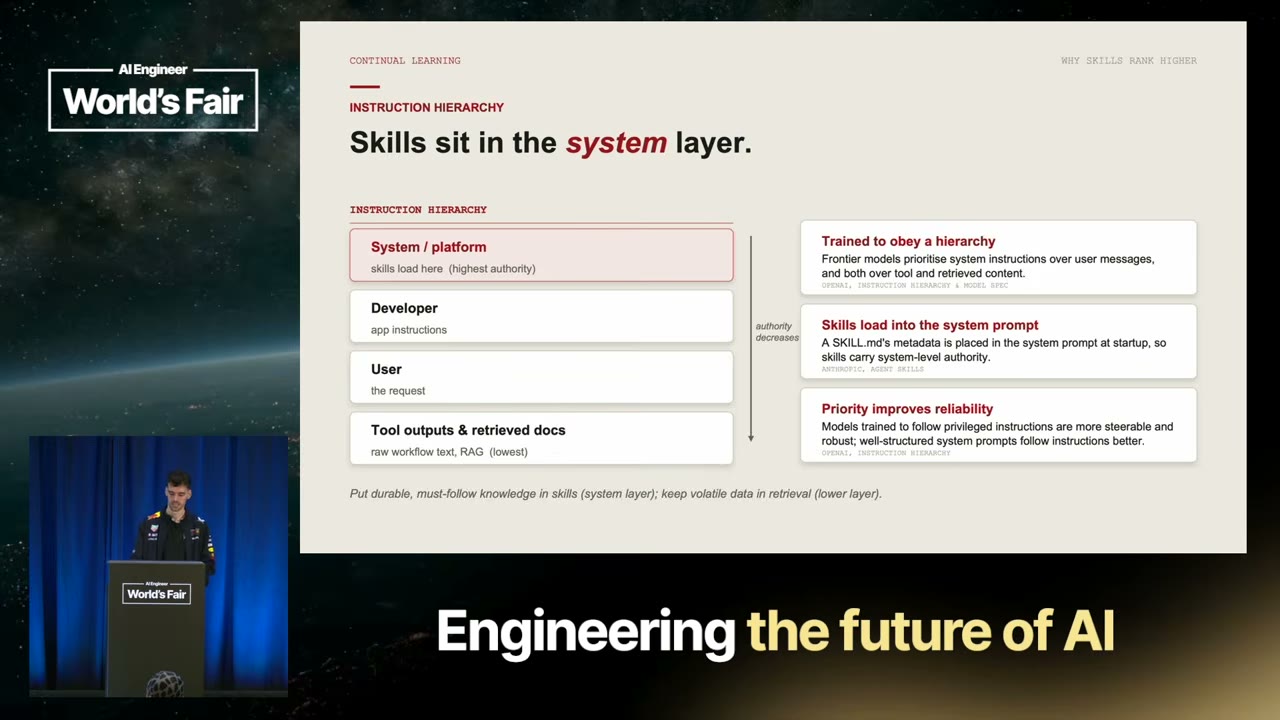
Инструкции системного уровня обладают наивысшим приоритетом над сообщениями пользователя и выдачей инструментов. Продвижение навыков (Skill Promotion) позволяет дистиллировать успешные многочасовые трассы в постоянные регламенты SKILL.md.
Переменная гистерезиса (Hysteresis)
Обвязка должна задавать точный лимит терпения (обычно 8–12 шагов цикла для frontier-моделей). Если задача не сходится, агент не должен тратить бесконечный бюджет на галлюцинации: управление передается человеку или маршрутизатору моделей.
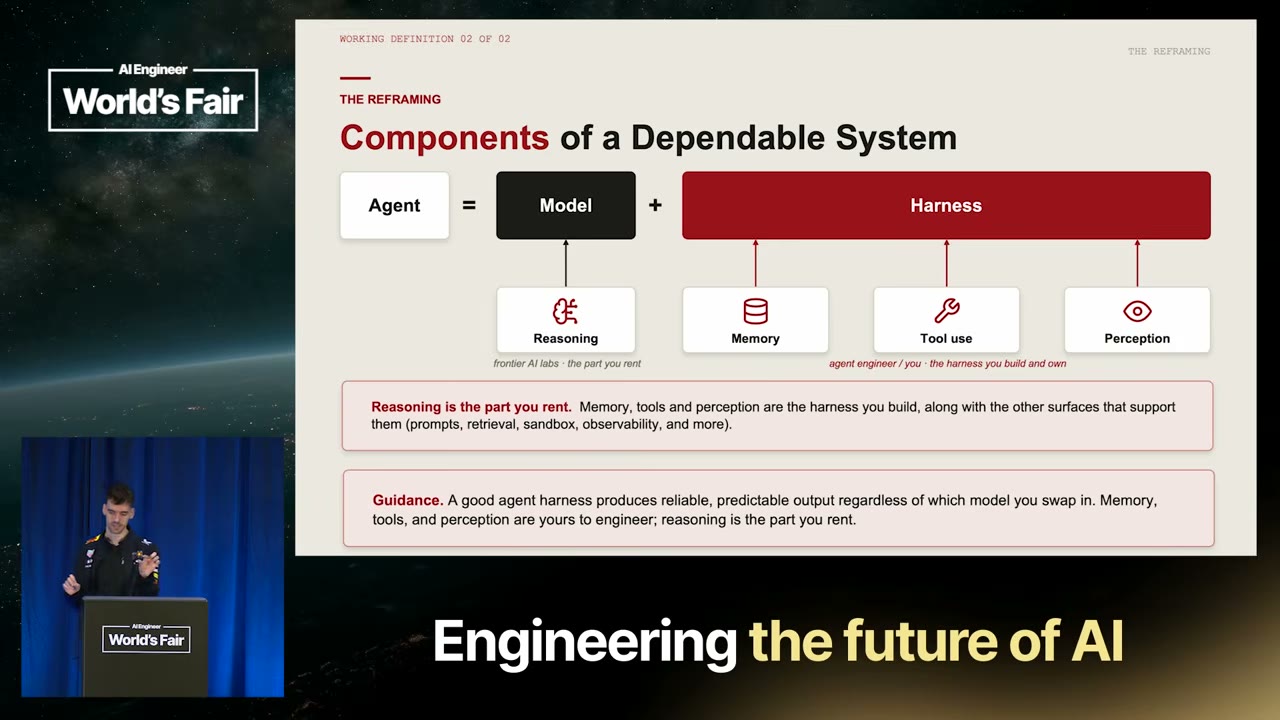
Компоненты надёжной системы: Модель против Обвязки
Разделение зон ответственности между фронтирной моделью и инженерным каркасом.
Модель недетерминирована по своей природе: один и тот же запрос может дать разные результаты. Задача инженерии обвязки — превратить недетерминированное ядро в воспроизводимую и надёжную бизнес-систему.
 🔍 клик для зума
7 слоев Harness Engineering
Пошаговый разбор инженерных слоев, превращающих модель в автономного агента.
Model Layer (Слой модели)
Застывшее ядро рассуждений (Frozen reasoning core). Сетевой вызов чат-модели взаимозаменяем через стандартные протоколы (OpenAI/Anthropic API). Внутренние модели (эмбеддеры и кросс-энкодеры) работают внутри СУБД на ONNX.
Storage Layer (Слой хранения)
Физическое размещение памяти: файлы и базы данных. Файлы удобны модели для дозаписи, но не обладают транзакционностью. База данных даёт ACID, изоляцию параллельных агентов и векторные индексы.
Encoding & Retrieval (Поиск)
Превращение сырого текста в смысловые векторы и извлечение срезов. Двухэтапный пайплайн: bi-encoder для первичного векторного отбора (top-k через HNSW) + cross-encoder для точного переранжирования (rerank).
Memory Layer (Слой памяти)
Четыре типа памяти агента: эпизодическая (события и тред), семантическая (факты и правила), процедурная (проверенные навыки) и рабочая (кратковременный scratchpad / to-do лист).
Semantic Layer (Семантический слой)
Обучение агента смыслу корпоративных данных (Umwelt). Задает структуру таблиц, негласные правила компании и скрытый словарь терминов, который не проговаривается явно в диалоге.
Agent Loop (Агентный цикл)
Типизированный граф управления всеми верхними слоями. Реализует цикл Observe → Reason → Act. Обеспечивает отказоустойчивость: ошибки выполнения инструментов перехватываются и возвращаются модели на доработку.
Context Engineering (Контекст)
Поддержание высокой плотности и актуальности окна контекста по мере роста сессии. Предотвращение деградации внимания через динамическое сжатие (Compaction) и выгрузку данных (Offloading).
Дилемма хранения: Файлы против Баз данных
Почему современные AI-инженеры переизобретают транзакции через Git Worktrees.
📁 Файловый подход
- Плюсы: Идеально соответствует природе модели; низкий порог входа; POSIX-совместимость с любой ОС; дешёвая дозапись логов (append-only).
- Критический изъян: Полное отсутствие транзакционной согласованности (ACID).
- Проблема мультиагентности: Если 8–32 агента одновременно пишут в файл (например, обновляют общий счётчик или файл состояния), они неизбежно перезаписывают результаты друг друга.
- Костыль индустрии: Использование отдельных
git worktreeна каждого агента с последующим ручным слиянием (merge) в main.
🗄️ Базы данных (СУБД)
- Плюсы: ACID-транзакции; строгая изоляция параллельных процессов; Row Level Security (RLS) по пользователям/агентам; встроенные векторные индексы (HNSW); надёжные бэкапы.
- Почему про них забыли: Считаются избыточно структурированными для неструктурированных рассуждений модели.
- Решение Oracle: DBFS (Database File System) и конвергентная БД — файлы и векторные коллекции живут внутри СУБД с транзакционной гарантией.
- Гибридная стратегия: Кратковременная рабочая память живёт в файлах, а проверенные знания и профили продвигаются в БД.
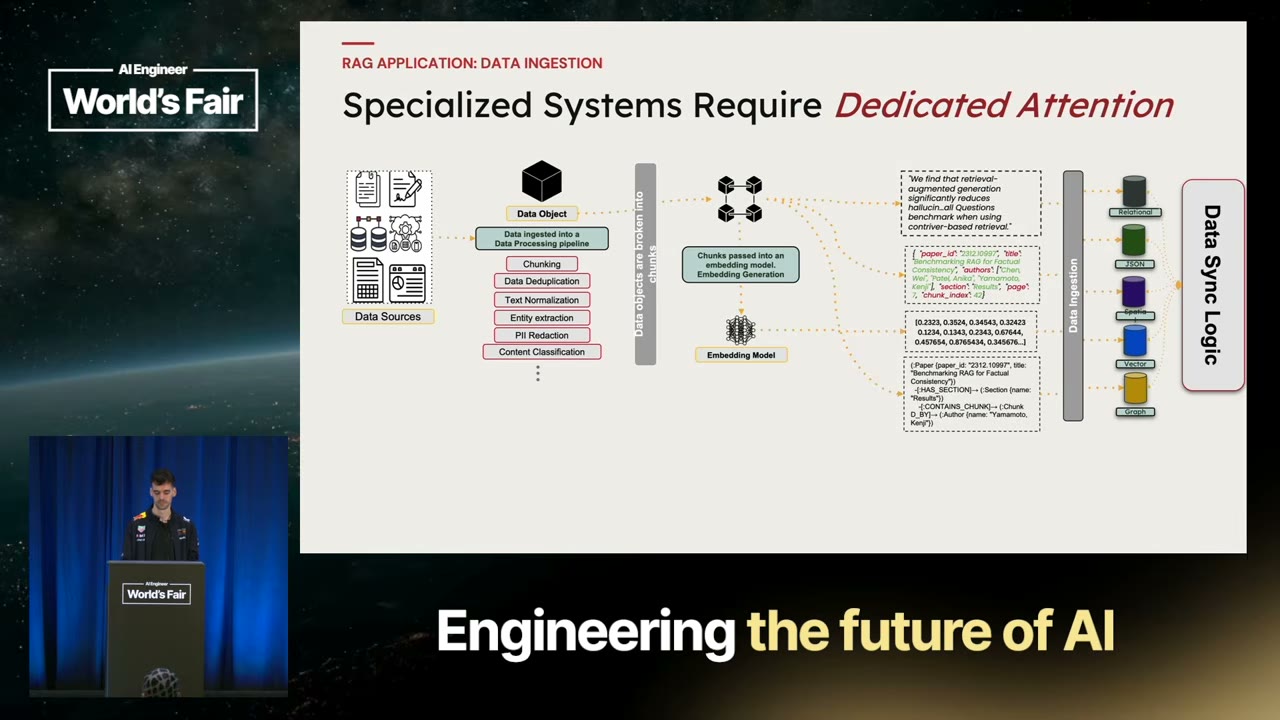
Фрагментация данных в RAG и Data Sync Logic
Как разделение хранилищ на 5 узкоспециализированных систем создаёт ад синхронизации.
Типичный RAG-пайплайн разбивает документы на куски и раскладывает их по отдельным хранилищам:
- Реляционные данные: PostgreSQL / MySQL
- Метаданные документов: JSON в MongoDB / DocumentDB
- Векторы эмбеддингов: Pinecone / Milvus / Qdrant
- Связи и сущности: Графовая база (Neo4j)
- Географические метки: Пространственные индексы (GIS)
Результат: Инженер тратит 80% времени на логику синхронизации данных (Data Sync Logic), решая проблемы расхождения версий, двойной записи и множественных точек отказа.
 🔍 клик для зума
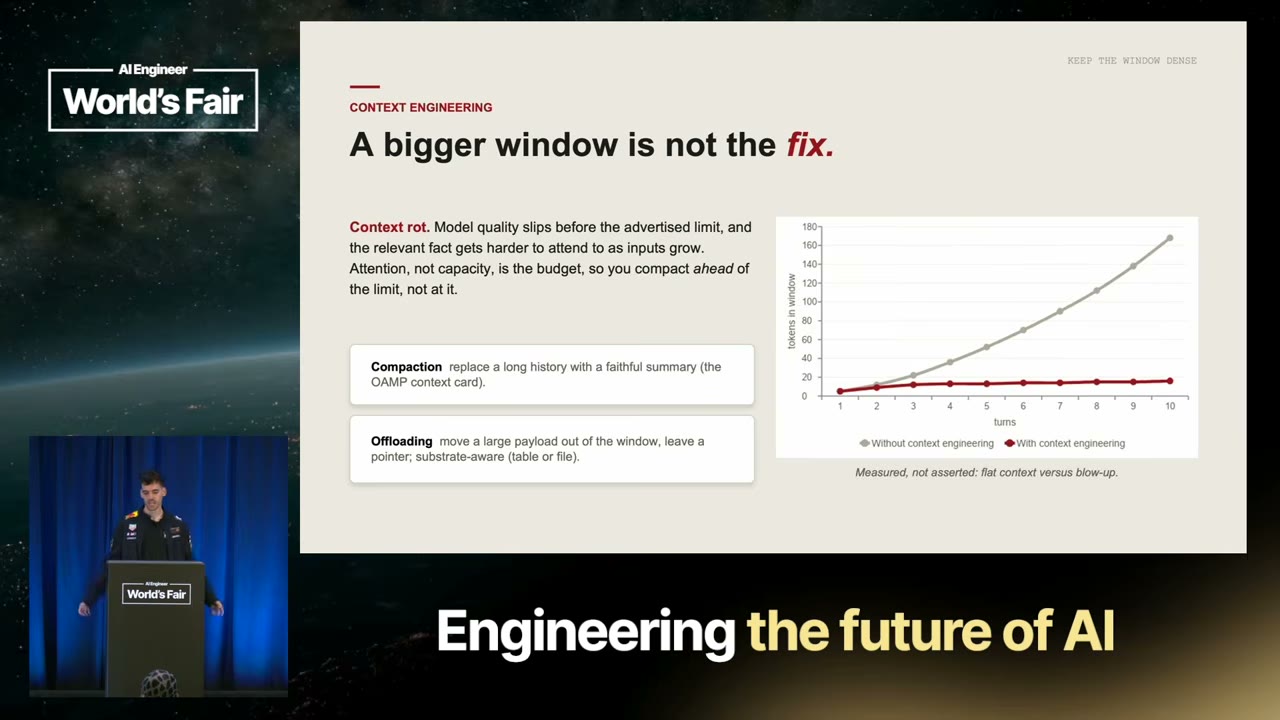
Context Rot и квадратичное внимание: почему окно контекста не спасёт
Почему гигантское окно контекста — это ловушка, снижающая качество рассуждений.
Суть проблемы: Матрица внимания трансформера сопоставляет каждый токен со всеми остальными. При росте окна матрица растёт по закону $O(N^2)$ по строкам и столбцам. Внимание размывается, модель пропускает ключевые факты и начинает галлюцинировать.
 🔍 клик для зума
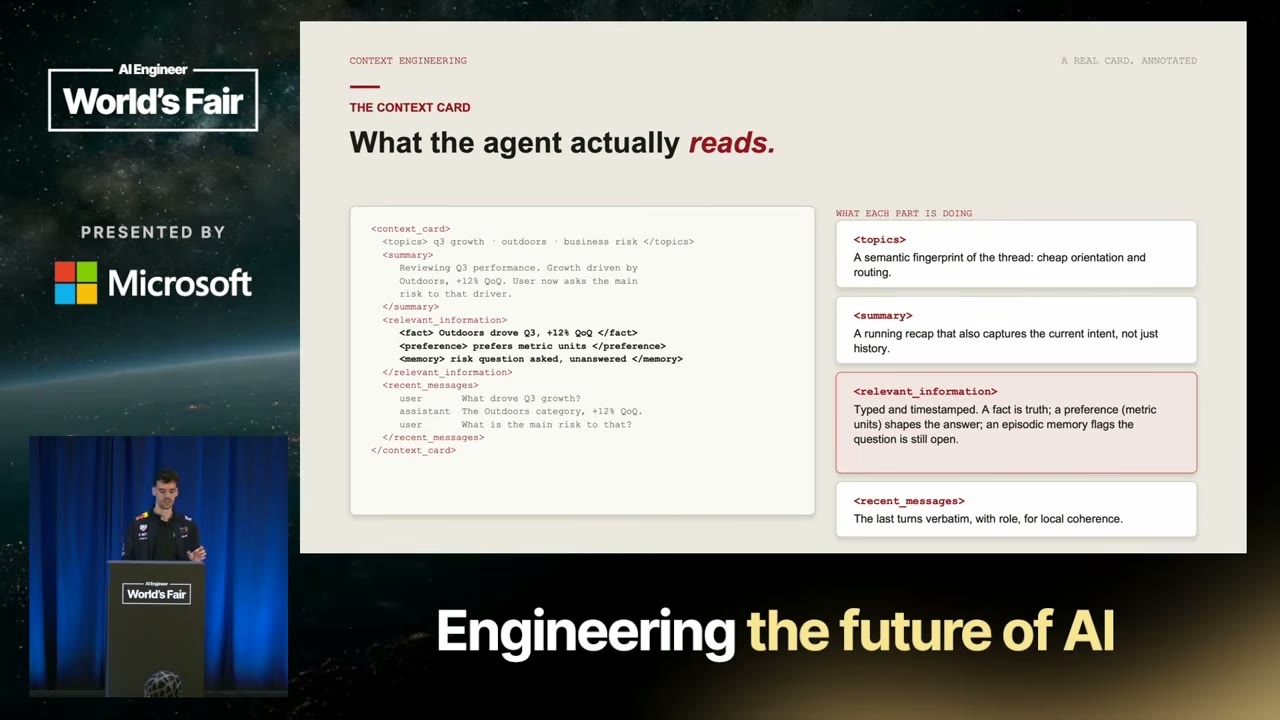
Context Card: что агент реально читает на каждом шаге
Стандартизованный XML-формат контекстной карточки из пакета Oracle Agent Memory (OAMP).
Карточка собирается в один вызов библиотеки oracleagentmemory и передается в модель в начале каждого хода вместо раздутой истории из сотен реплик.
 🔍 клик для зума
<topics> — семантический отпечаток треда для маршрутизации; <summary> — сжатие текущего намерения; <relevant_information> — факты, предпочтения и незакрытые вопросы; <recent_messages> — локальная связность диалога.
Umwelt и семантический слой: невысказанное знание
Как заложить в агента контекст, который коллеги понимают без слов.
Концепция Umwelt (Якоб фон Икскюль)
Биолог Якоб фон Икскюль показал, что каждое живое существо воспринимает реальность исключительно через призму своих органов чувств. Клещ реагирует только на температуру и масляную кислоту; летучая мышь — на эхолокацию. У агента нет человеческих чувств — его Umwelt формируется исключительно тем, что мы положили в семантический слой.
Скрытый корпоративный словарь
Когда опытные инженеры общаются между собой, они опускают 80% контекста: названия сервисов, логику связей таблиц, форматы дат и регламенты развертывания. Для нового стажёра всё это нужно расписывать подробно. Семантический слой фиксирует именно это институциональное знание (tribal knowledge) компании.
Масштабирование инструментов через HNSW
Что делать, если в корпоративной системе тысячи инструментов? Их нельзя засунуть в один промпт. Решение: векторный граф HNSW, где описания функций дополняются моделью (LLM-enhanced docstrings) для высокой сепарабельности при семантическом поиске нужного инструмента на каждом шаге.
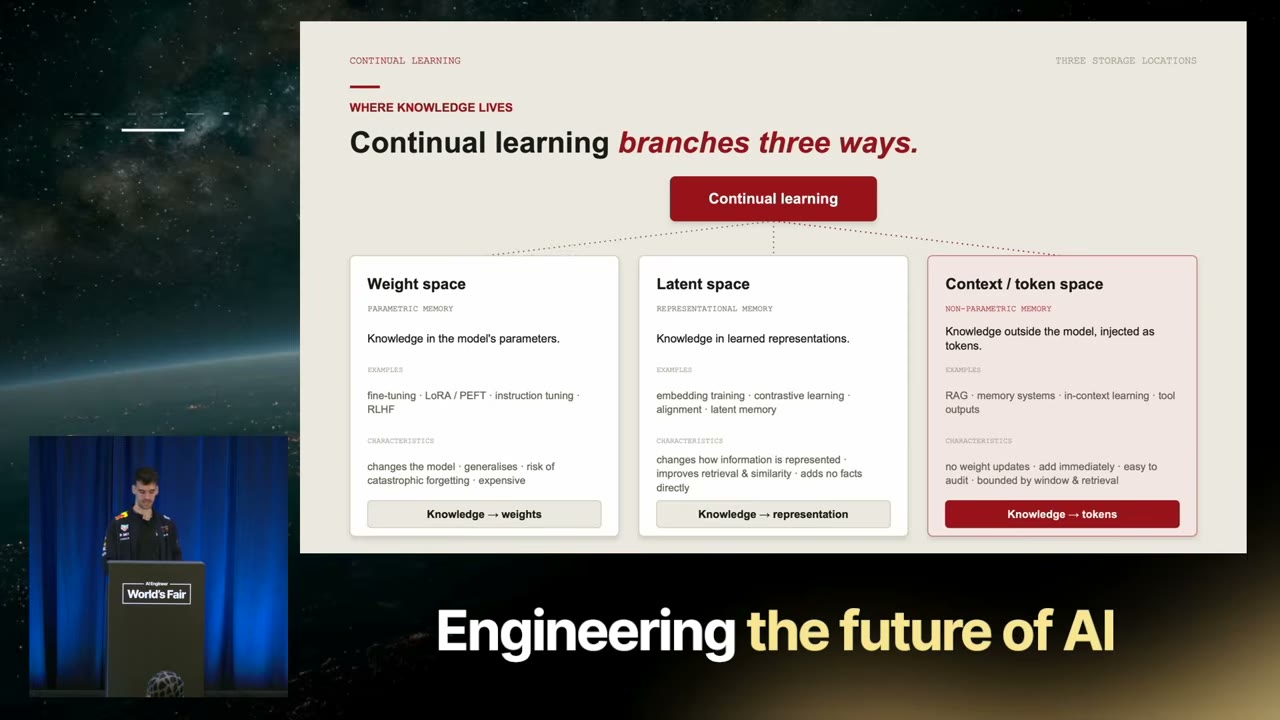
Продвижение навыков (Skill Promotion) и Иерархия инструкций
Как агент обучается на собственном опыте без дообучения весов модели.
 🔍 клик для зума
 🔍 клик для зума
SKILL.md) помещаются на уровень System/Platform — высший авторитет перед инструкциями разработчика, пользователя и выдачей инструментов.
Механизм Skill Promotion (Продвижение навыка)
Если решение нестандартной инженерной задачи заняло у агента 4 часа и потребовало 15 шагов проб и ошибок, обвязка запускает процесс дистилляции. Успешная траектория очищается от тупиковых путей и оформляется в обновленный файл SKILL.md. Старая версия навыка выводится из эксплуатации. При следующем столкновении с похожей задачей агент решает её по готовому регламенту за 2 минуты.
Хронологический таймлайн доклада
Ключевые вехи воркшопа с прямыми ссылками на видео и миниатюрами слайдов.
Игнасио Мартинес открывает воркшоп, рассказывает о регистрации домена за два дня до события и просит участников не запрашивать самые мощные инстансы GitHub Codespaces, так как оплачивает их из своего кармана.
Главная цель занятия: понять практическую инженерию памяти агентов и научиться собирать собственную минимальную обвязку, не зависящую от конкретного поставщика моделей.
Веса модели зафиксированы. Мы не можем дообучать их во время выполнения запроса без миллионов долларов и кластеров GPU. Поэтому всё обучение в реальном времени переносится в обвязку.
Стек состоит из Application, Data, Model, Infrastructure и Compute. Все слои, кроме Data, стремительно коммодитизируются крупными облачными провайдерами. Слой данных и памяти — главная точка контроля инженера.
Формальное определение: «Агент — это автономная сущность, когнитивные функции которой обеспечены языковой моделью для рассуждений, дополнены базой данных или файлами для памяти, расширены инструментами для действий и заземлены в окружении».
Разбор максимализма: почему разработчики предпочитают файлы для промптов, но спотыкаются о параллельную запись нескольких агентов. Зал отвечает: изоляция через Git Worktrees. Мартинес напоминает, что базы данных решили проблему ACID ещё 40 лет назад.
Демонстрация переусложненных пайплайнов извлечения, где текст, векторы, метаданные и графы раскладываются по разным СУБД. Решение Oracle: единая конвергентная база данных (Converged Database) с общим интерфейсом запросов.
Математика матрицы внимания: внимание — ограниченный бюджет, масштабируемый квадратично. При разрастании истории модель теряет способность фокусироваться на нужных фактах. Сжатие истории (Compaction) должно выполняться задолго до исчерпания лимита окна.
Представление реальной структуры Context Card из библиотеки Oracle Agent Memory Package. Разбор блоков topics, summary, relevant_information и recent_messages.
Введение понятия Umwelt биолога Якоба фон Икскюля. Семантический слой фиксирует институциональное знание компании — скрытый словарь, не проговариваемый инженерами вслух.
Сравнение трех подходов к непрерывному обучению: параметрическая память (веса), репрезентативная память (эмбеддинги) и непараметрическая контекстная память (токены). Обоснование фокуса на контекстном пространстве.
Почему навыки и спецификации SKILL.md должны загружаться в системный промпт. Принцип приоритета инструкций: System > Developer > User > Tool outputs.
Ответ на проблему тысяч API в enterprise: использование HNSW-графов в базе данных и автоматическая генерация LLM-обогащенных описаний функций для повышения различимости (separability) векторов инструментов.
Введение концепции переменной гистерезиса (Hysteresis variable). Определение оптимального лимита шагов (8–12 вызовов для Grok 4.1 Fast Reasoning) до принудительного прерывания цикла и эскалации.
Ключевые цитаты спикера
Формулировки, определяющие инженерный подход к памяти и архитектуре агентов.
Рекомендации для AI-инженера: Чек-лист проектирования обвязки
Практические шаги по построению отказоустойчивой обвязки для ваших агентов.
-
Изолируйте вызовы моделей за единым интерфейсом Сделайте слой рассуждений (Model Layer) полностью заменяемым. Обвязка должна функционировать одинаково надежно при подмене frontier-модели от OpenAI на Anthropic, xAI или локальную open-weights модель.
-
Определитесь со стратегией конкурентного доступа Если ваши субагенты работают параллельно над общим кодом или состоянием, используйте либо Git Worktrees для изоляции изменений на диске, либо перенесите память состояния в базу данных с ACID-транзакциями.
-
Внедрите превентивное сжатие (Compaction) истории Не полагайтесь на расширенное окно в 1–2 миллиона токенов. Сжимайте тред в Context Card со структурированными блоками (topics, summary, facts, open questions) задолго до достижения лимита внимания.
-
Размещайте регламенты и навыки (Skills) на системном уровне Загружайте метаданные и инструкции навыков в System Prompt, а не в выдачу инструментов или сообщения пользователя, чтобы обеспечить наивысший приоритет выполнения и защиту от инъекций.
-
Задайте переменную гистерезиса (Hysteresis) для цикла агента Установите жесткий лимит шагов в цикле Observe → Reason → Act (обычно 8–12 вызовов). При превышении лимита переключайте модель на более мощную или запрашивайте подтверждение у человека.
-
Используйте Toolbox Pattern при числе инструментов более 20 Индексируйте функции в векторном хранилище (HNSW) и динамически подгружайте в контекст только релевантные инструменты для текущего хода вместо раздувания схемы промпта.